

Espiar a Tu Competencia de Manera Legal es Posible
Espiar a Tu Competencia de Manera Legal es Posible

¿Cómo se obtiene datos de usuario de páginas que te interesa monitorear?
Usando datos públicos de Google!
No es necesario un scraper o suscripciones costosas a wappalyzer.
Solo necesitas
- La base de datos en bq y api de crux.
- La base de datos de http archive en bq.
Decisiones de Arquitectura
Primero veamos la naturaleza de las fuentes de datos
Las BD de crux y http archive se actualizan mensualmente. Crux tiene un retraso de 2 meses, mientras que http archive de solo 1 mes. Esta diferencia tiene impacto para el análisis de datos. Por eso conviene etiquetar el mes de provenance de cada dato que ingrese a nuestro data lake.
Por otro lado, para el usuario final que solo quiere ver reportes, la diferencia de 1 mes no importa mucho. Incluso se podría interpretar como un retraso de procesamiento o algun desfase insignificante entre los gráficos históricos.
Ahora, si nos enfocamos en el volumen de datos, cada base de datos utiliza como identificador un campo llamado origin, que podemos interpretar como el dominio web del que se sirve el contenido y las aplicaciones.
Cada origin tiene decenas de columnas en total. Pero al fin de al cabo, un tamaño fijo de datos. Esto significa que el volumen de datos crece, dados los parámetros
- N: número de origins a analizar
- T: cantidad de unidades temporales a analizar,
... con complejidad O(NT). Para mi lista inicial de dominios peruanos registré 20mil dominios y mi objetivo es mantener una ventana de 24 semanas en el reporte. Dudo que en el futuro supere los 100mil dominios, así que tenemos un volumen modesto de datos que se puede procesar en un solo nodo, o mi computadora.
Requisitos y restricciones
Entre otros requisitos más específicos,
- Quiero almacenar los datos históricos y enrichment en un formato de bajo costo de almacenamiento pero con alta garantía de integridad de datos.
- Mi página de reportes debe tener alta disponibilidad y presentar una experiencia de usuario fluida.
- Quiero mantener costos de mantenimiento mínimos.
AWS S3 + Athena, GCP BigQuery Iceberg Catalog... hay muchas soluciones en el mercado. Esta vez decidí usar Cloudfare R2 Data Catalog, con una generosa cuota de 10GB de almacenamiento gratis y alto número de lecturas y escrituras.
En cuanto a la página, Astro es mi opción preferida en estos casos. Y la CDN será CloudFare para mantener sencillez de administración.
Transformación De Datos
Las etapas de extracción, filtro y enrichment son sencillas.
Sin embargo, http archive no entrega categorías tecnológicas normalizadas. Como usa el motor de firmas de wappalyzer, simplemente entrega categorías de lo que sea que detecte. Puedes tener React.js y Next.js a la vez, incluso cuando sabemos que Next.js es un meta-framework de React y no existe sin este.
Anteriormente, desde julio a septiembre utilizaba el siguiente categorizador en 2 etapas.
Etapa 1: Remapeo a Macrocategorías
 Remapeo de categorías crudas a macrocategorías normalizadas.
Origin_Technologies de R2 con una lista de categorías por tecnología. Después de agruparlas tenemos menos complejidad con la que trabajar. Pero es en esta etapa en la que hacemos el trabajo sucio.
Etapa 2: Limpiando empates.
 LinearUntie: colapsando tecnologías atadas a una misma macrocategoría.
Nuevo Clasificador
Sin embargo me di cuenta de que la complejidad del modelo anterior era muy alta. Era casi seguro que estaba haciendo overfit. Lo que hice entonces fue construir un dataset de evaluación con 200+ filas.
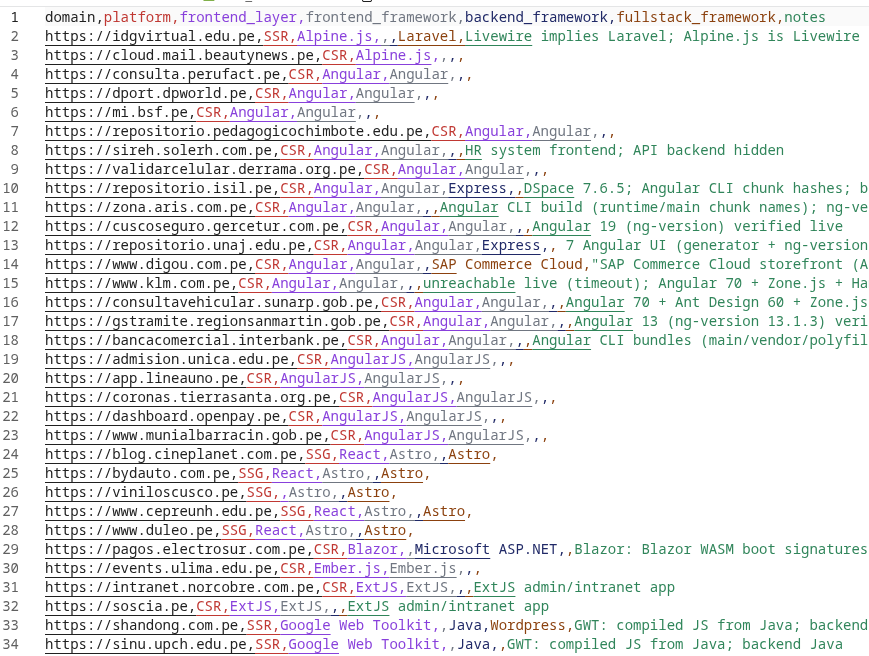
Ahora con una evaluación objetiva de base, escogí selective F1 para medir mi modelo. O sea, el F1 efectivo de las predicciones en las que el modelo no emitió null.
Y los resultados fueron desalentadores. Apenas un 40% de coverage, incluso si el F1 era de 90%. Esto da un Selective F1 = 40% * 90%, menos que 50%.
Es por eso que me decidí a seguir un enfoque más simple esta vez.

Una vez que hemos aplanado la lista de tech de un dominio, reconstuirmos el mapa de categorías tecnológicas. Para esto construí mi propia taxonomía con lenguaje más usado en el campo. A cada item del pool de taxonomías le asigno un peso de acuerdo a qué tan difícil creo que será clasificarlo.
- Frontend Layer. Aquí entran todas las librerías y tecnologías que solo se ven de cara al cliente, esto es, el navegador. Verás jQuery, React.js, WASM Blazor Pages, y para los casos de SSR queda como null.
- Frontend Framework. Aquí tenemos frameworks opinionados como Astro, Angular, React SPA, JSP, entre otros. Ya no basta con tener una librería de frontend, sino que imponga cierta estructura.
- Backend Framework. Cuando un componente web actúa únicamente como servidor de datos. Next.js puede entrar como backend, del mismo modo que .NET. Sin embargo, existen backend puros que será difícil identificar, por ejemplo Spring Boot, Node.js/Express, Django, Nest, y este campo no espero que tenga mucha cobertura.
- Fullstack Framework. A este súmale los fullstack monolíticos puros como WordPress, Shopify, Java EE + JSP/JSF, .NET + Razor Pages. Entre los modernos tenemos a Next.js y Nuxt, por ejemplo.
La idea central es que solo se pueda identificar 1 ganador por cada taxonomía. Además Fullstack Framework debe ser excluyente con Backend Framework o Frontend Framework. Yo sé que hay muchas páginas híbridas en las que puede convivir WordPress con Angular, por poner un ejemplo. Sin embargo esto solo agrega complejidad al modelo.
dump = {
    name.strip(): float(value) * BASE_CONFIDENCE.get(name.strip(), 1.0)
    for name, value in confidences.items()
}
best_fs, fs_second = _top_two(frozenset(CLOSED_MONOLITHS | DUAL_RUNTIMES), dump)
best_be, be_second = _top_two(frozenset(PURE_BACKENDS | DUAL_RUNTIMES), dump)
best_fe, fe_second = _top_two(FRONTEND_FRAMEWORKS, dump)
best_layer, layer_second = _top_two(PRESENTATION_LAYERS, dump)
Luego, revisamos los casos de clasificación monolítica. Para tener certeza de que se está usando Laravel monolítico, vale la pena tener indicadores como stack nativo.
NATIVE_ECOSYSTEM: dict[str, frozenset[str]] = {
  "Astro": frozenset({"React", "Svelte", "Vue.js"}),
  "Django": frozenset(),
  "Drupal": frozenset({"jQuery", "PHP"}),
  "Jakarta EE": frozenset({"JavaServer Faces", "JavaServer Pages"}),
  "Java EE": frozenset({"JavaServer Faces", "JavaServer Pages"}),
  "Joomla": frozenset({"jQuery", "PHP"}),
  "Laravel": frozenset({"Blade", "Vue.js"}),
  "Microsoft ASP.NET": frozenset({"Blazor", "jQuery"}),
  "Next.js": frozenset({"React", "Preact"}),
  "Nuxt.js": frozenset({"Vue.js"}),
  "Ruby on Rails": frozenset({"Hotwire"}),
  "Spring Boot": frozenset({"JavaServer Pages", "Thymeleaf"}),
  "SvelteKit": frozenset({"Svelte"}),
  "WordPress": frozenset({"jQuery", "PHP"}),
  "React": frozenset({"React Router", "React Redux"}),
}
Finalmente generamos la predicción.
headless = _is_headless(best_fs, best_fe, best_layer)

chosen_fs: str | None = None
chosen_be: str | None = None
chosen_fe: str | None = None
chosen_layer: str | None = None

if headless:
    if _gap_ok(best_fs, fs_second, settings) and best_fs is not None:
        chosen_be = best_fs.name
    if _gap_ok(best_fe, fe_second, settings) and best_fe is not None:
        chosen_fe = best_fe.name
    if _gap_ok(best_layer, layer_second, settings) and best_layer is not None:
        chosen_layer = best_layer.name
elif best_fs is not None and _gap_ok(best_fs, fs_second, settings):
    chosen_fs = best_fs.name
    if best_fs.name in CLOSED_MONOLITHS:
        chosen_layer = IMPLIED_NATIVE_LAYER.get(best_fs.name)
    if chosen_layer is None and best_layer is not None and _gap_ok(
        best_layer, layer_second, settings
    ):
        chosen_layer = best_layer.name
else:
    if _gap_ok(best_be, be_second, settings) and best_be is not None:
        chosen_be = best_be.name
    if _gap_ok(best_fe, fe_second, settings) and best_fe is not None:
        chosen_fe = best_fe.name
    if _gap_ok(best_layer, layer_second, settings) and best_layer is not None:
        chosen_layer = best_layer.name

return StackResult(
    fullstack_framework=chosen_fs,
    backend_framework=chosen_be,
    frontend_framework=chosen_fe,
    frontend_layer=chosen_layer,
)
Y, sorprendentemente, este simple modelo con reglas genera Selective F1 > 70% para las columnas que nos importan.
Ya lo puedes ver en vivo en la página. He compuesto una categoría con nombre Web Framework que es FrontendFramework | FullStackFramework, que identifica en una palabra el stack que se puede obtener al scrapear una página.
Sobre las demás categorías, todavía usan el modelo antiguo, pero actualizaré esta entrada de blog acorde al cambio próximo.
Ranking
Una vez que ya tienes los conjuntos de datos normalizados el ranking se vuelve una tarea de estadística, y la página de reportes un proceso de diseño y UI.
The UX Report
Si te interesa validar los resultados que ves en la web o alguna publicación, estos son los pasos.
Cómo reproducir tu severity y tu score con la API pública de CrUX
Lo que se muestra en la sección Core Web Vitals sale directo de la Chrome UX Report API de Google y que se usan en su ranking de SEO.
1. Pide un histograma a través de la CrUX API
curl --request POST \
  'https://chromeuxreport.googleapis.com/v1/records:queryRecord?key=TU_API_KEY' \
  --header 'Accept: application/json' \
  --header 'Content-Type: application/json' \
  --data '{"origin":"https://tu-dominio.pe"}'
La respuesta trae, por cada métrica, un histogram de 3 bins: bueno / necesita mejora / malo — cada uno con una density (fracción real de visitas de usuarios reales en ese rango, no un promedio sintético):
"largest_contentful_paint": {
  "histogram": [
    { "start": 0,    "end": 2500, "density": 0.82 },
    { "start": 2500, "end": 4000, "density": 0.11 },
    { "start": 4000,               "density": 0.07 }
  ],
  "percentiles": { "p75": 2380 }
}
Las tres métricas que importan son largest_contentful_paint (LCP), cumulative_layout_shift (CLS) e interaction_to_next_paint (INP). Los core web vitals oficiales de Google.
2. Calcula el severity de cada métrica
Por cada métrica, el severity es un promedio ponderado por la densidad real de cada banda:
severity_métrica = poor × 1.0 + needs_improvement × 0.5 + good × 0.0
Con el ejemplo de arriba: 0.07 × 1.0 + 0.11 × 0.5 + 0.82 × 0.0 = 0.125.
¿Por qué ponderado y no "banda dominante"? Porque un origen con 51% good / 49% needs-improvement y otro con 99% good / 1% needs-improvement son historias reales muy distintas
3. Promedia las tres métricas
def metric_severity(good: float, ni: float, poor: float) -> float:
    return poor * 1.0 + ni * 0.5 + good * 0.0

severity = (
    metric_severity(*lcp_densities)
    + metric_severity(*cls_densities)
    + metric_severity(*inp_densities)
) / 3
severity queda entre 0 (perfecto) y 1 (el peor caso posible). Si a tu origen le falta alguna de las tres métricas en esta ventana (CrUX exige un mínimo de tráfico por métrica para publicarla) lo que hago es completar el dato con el promedio del cohorte de esa ventana de datos. En ese caso sí tendrías problemas para reproducir tu score completo, pero puedes usar un valor placeholder de 50% para llegar a un aproximado.
4. Tu score
score = round((1 - severity) * 100)
Con severity = 0.125, el score es 87/100. Este número es 100% reproducible por cualquiera con solo la API pública de Google.
Espero que te haya gustado el artículo. Recuerda que cada mes actualizo el reporte de páginas. Te veo en mis métricas de analytics pronto!
Colaboración
Tengo planeado liberar de manera open source el proyecto cuando entre en una etapa estable. Si quieres apoyar con alguna lista de URLs que consideras necesarias o una métrica que te gustaría tener escríbeme a mis redes con gusto.